

- ChatGPTやClaudeの会社は、ホームページを読みに来る巡回ロボット(クローラー)を用途ごとに分けています。「AIの学習用」「AI検索用」「利用者に頼まれて読みに行く用」の3つです。
- 分かれているので、「学習に使われるのは断るが、AI検索には出たい」という選び方ができます。指定は、サイトに置くrobots.txt(ロボッツ・テキスト)という小さなファイルに、ロボットの名前を書いて行います。
- ただしrobots.txtはお願いの札で、強制する力はありません。見られて困る情報を隠す道具でもありません。3社の公式ページの内容と、書き方・注意点をまとめます。
「うちのホームページの文章、勝手にAIの学習に使われていないか」「逆に、ChatGPTで調べた人にうちの会社が出てこないのは、何かを止めてしまっているからでは」——ホームページを持つ会社から、どちらの相談も聞くようになりました。
この2つは、実は同じ1つのファイルの話です。この記事では、OpenAI(ChatGPT)、Anthropic(Claude)、Googleの3社が公式ページに書いている内容をもとに、AIのロボットの見分け方と、通す・止めるの決め方を、専門用語をなるべく使わずにお伝えします。3社のページは、2026年10月9日に当社が原文を取得して確認しました(出典は記事末)。
AIの巡回ロボットは1種類ではない——用途は3つ
検索エンジンやAIの会社は、世界中のホームページを自動で読んで回るプログラムを動かしています。これが巡回ロボット(クローラー)です。
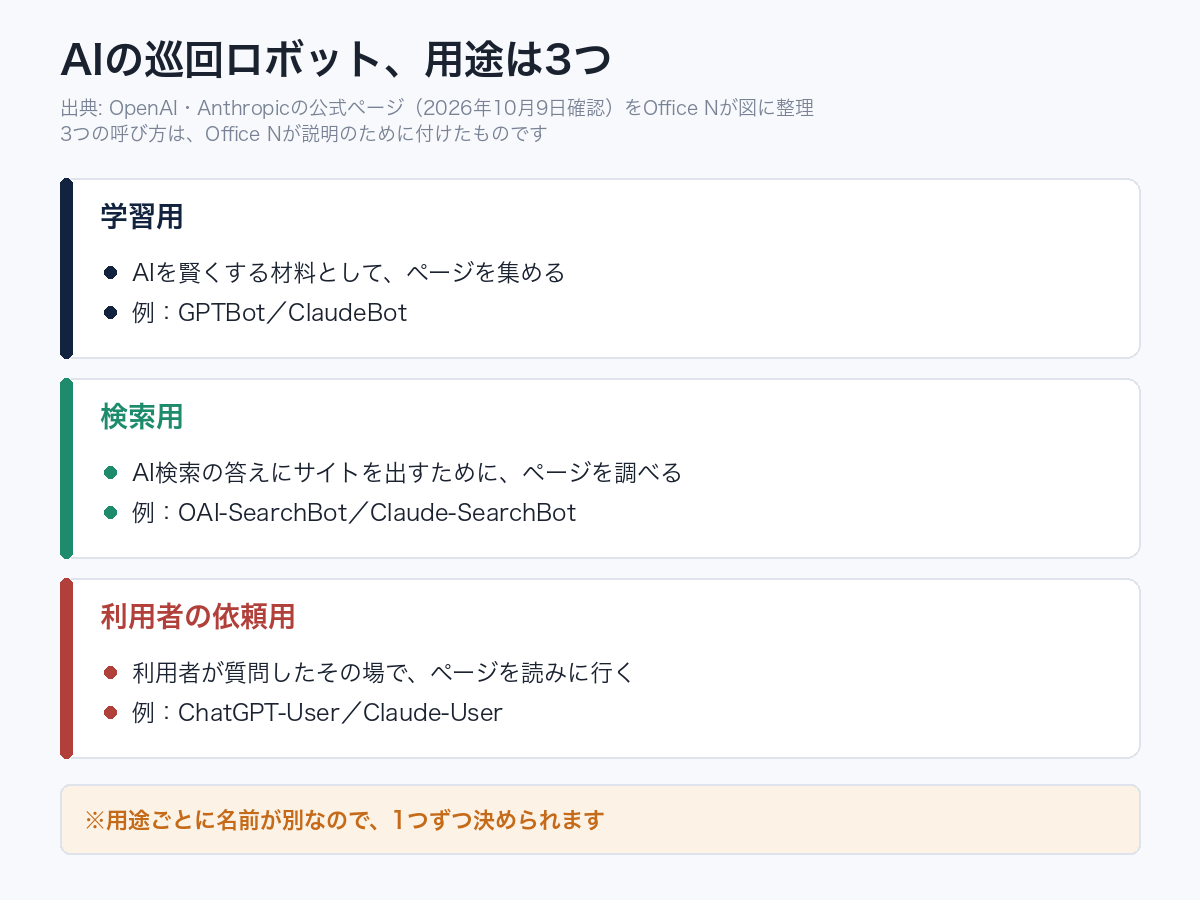
OpenAIとAnthropicの公式ページを読むと、どちらもロボットを用途ごとに別の名前で動かしています。Office Nが整理すると、用途は次の3つです。
- 学習用:AIそのものを賢くするための材料(学習データ)として、ページを集めるロボット
- 検索用:AIの検索機能で、答えの中にサイトを出すためにページを調べるロボット
- 利用者の依頼用:利用者がAIに質問したとき、その場でページを読みに行くもの
大事なのは、1つずつ別々に決められることです。OpenAIの公式ページには、設定はそれぞれ独立していて、たとえば検索用(OAI-SearchBot)は許可して検索結果に出つつ、学習用(GPTBot)は断ることができる、という趣旨が書かれています。
OpenAI(ChatGPT)のロボット——GPTBotとOAI-SearchBotは別物
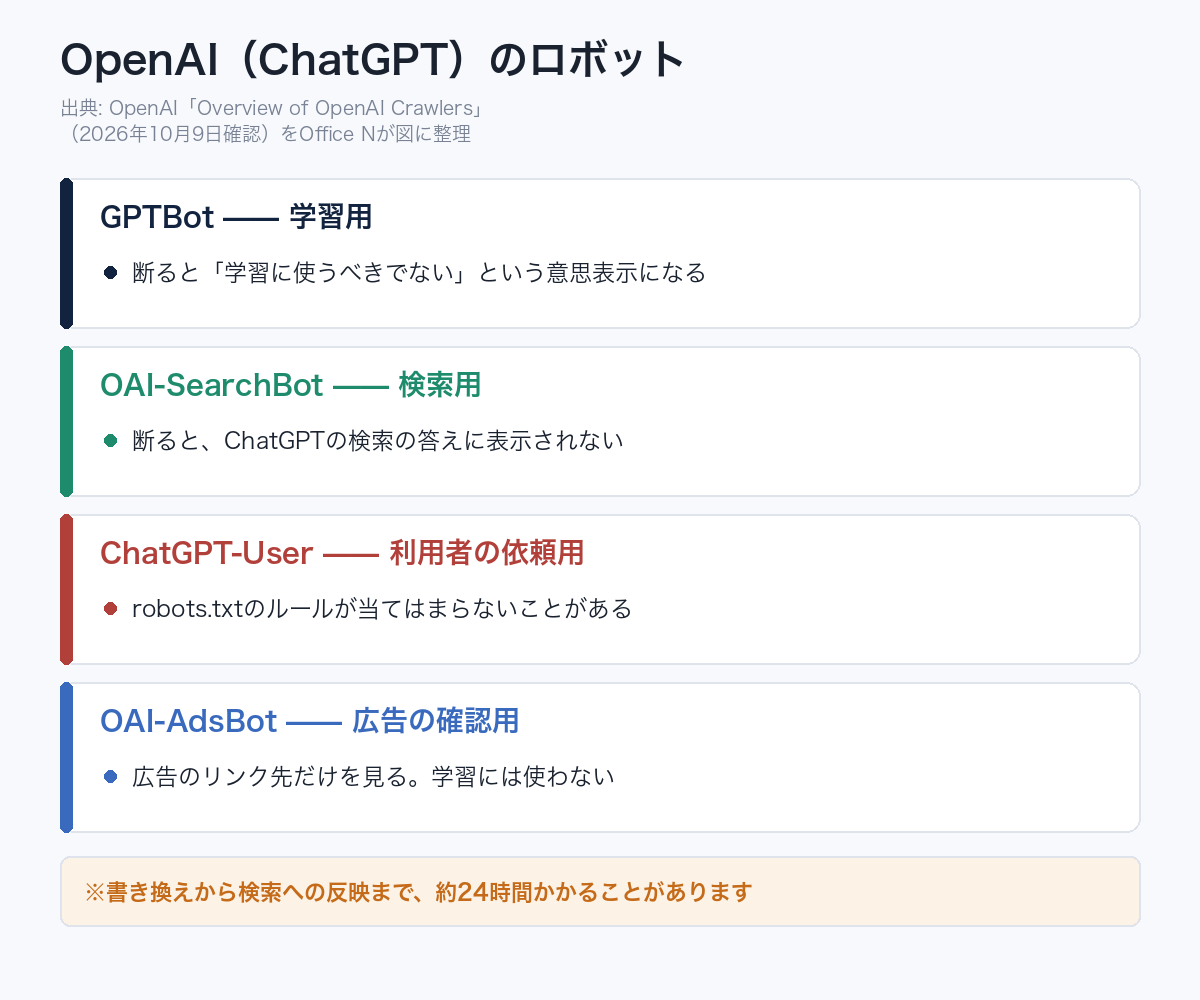
OpenAIの公式ページ「Overview of OpenAI Crawlers」には、次の名前が載っています。
- GPTBot(学習用):生成AIのモデルの学習に使われる可能性のある内容を集めます。GPTBotを断ると、そのサイトの内容を学習に使うべきではない、という意思表示になります
- OAI-SearchBot(検索用):ChatGPTの検索機能で、サイトを検索結果に出すために使われます。これを断ったサイトはChatGPTの検索の答えには表示されません(行き先を示すリンクとしては出ることがある、とされています)。OpenAIは、検索に出たいサイトには許可することを勧めています
- ChatGPT-User(利用者の依頼用):利用者がChatGPTに質問したときなどに、ページを見に行くことがあります。自動で巡回するためのものではなく、利用者が起こした動きなので、robots.txtのルールが当てはまらないことがある、と書かれています
- OAI-AdsBot:ChatGPTに広告を出したとき、そのリンク先のページが安全かを確かめるものです。広告として出されたページだけを見に行き、集めたデータは学習には使わないと書かれています
もう1つ、実務で知っておきたい一文があります。robots.txtを書き換えてから、検索の側に反映されるまで約24時間かかることがある、という注意書きです。書き換えた直後に「変わらない」とあわてなくて大丈夫です。
Anthropic(Claude)のロボット——3つの名前と、止めたときに起きること
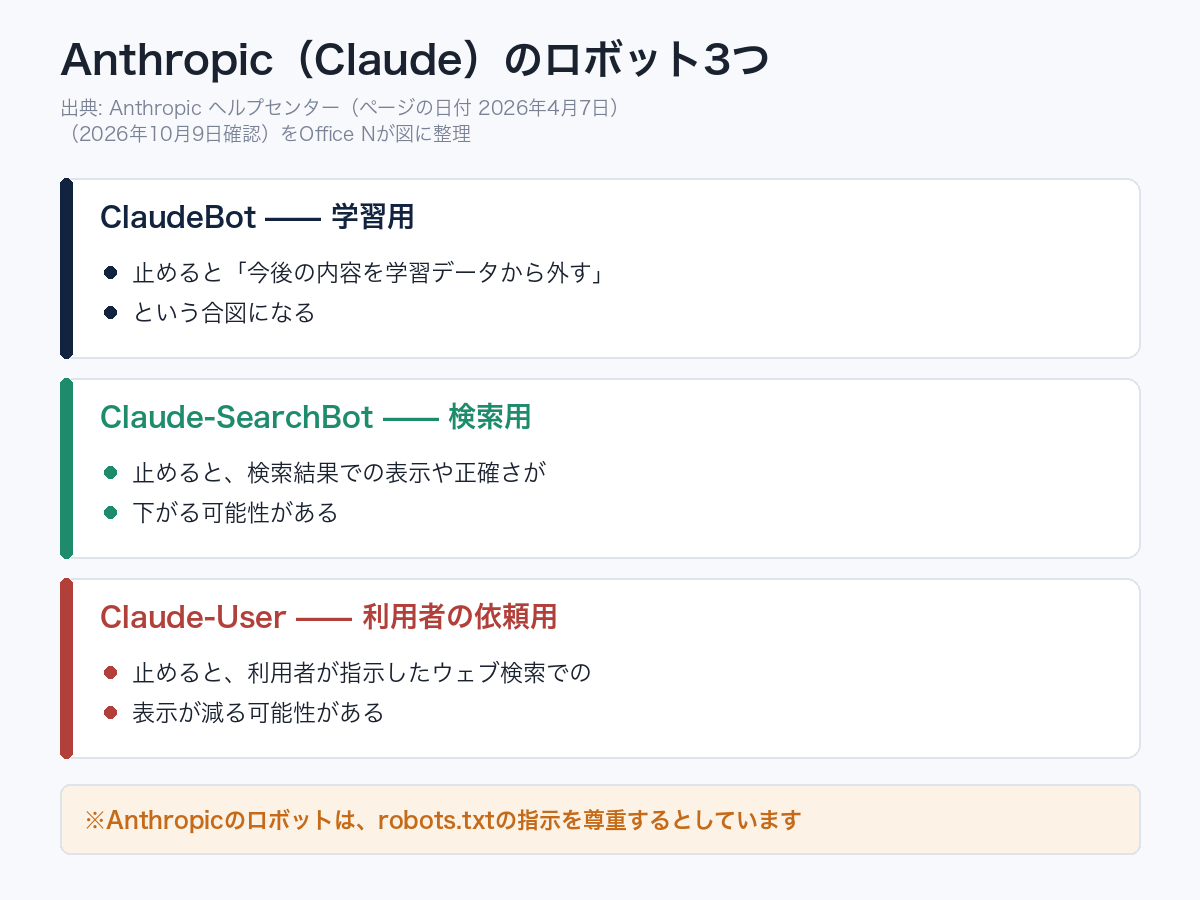
Anthropicのヘルプセンターには、3つのロボットと、それぞれを止めた場合に何が起きるかが表になっています。
- ClaudeBot(学習用):AIモデルの学習に役立つ可能性のあるウェブの内容を集めます。止めると、そのサイトの今後の内容を学習データから外すべきだ、という合図になります
- Claude-SearchBot(検索用):利用者の検索結果の質を上げるために、ウェブの内容を調べます。止めると、検索結果での表示や正確さが下がる可能性があるとされています
- Claude-User(利用者の依頼用):利用者がClaudeに質問したとき、サイトを見に行くことがあります。止めると、利用者の質問に応じて内容を取りに行けなくなり、利用者が指示したウェブ検索での表示が減る可能性があるとされています
同じページには、Anthropicのロボットはrobots.txtの指示を尊重すること、サイト側が置いている「人かどうかの確認」(CAPTCHA)をすり抜けようとしないこと、も書かれています。
Googleは仕組みが違う——Google-ExtendedとGooglebot
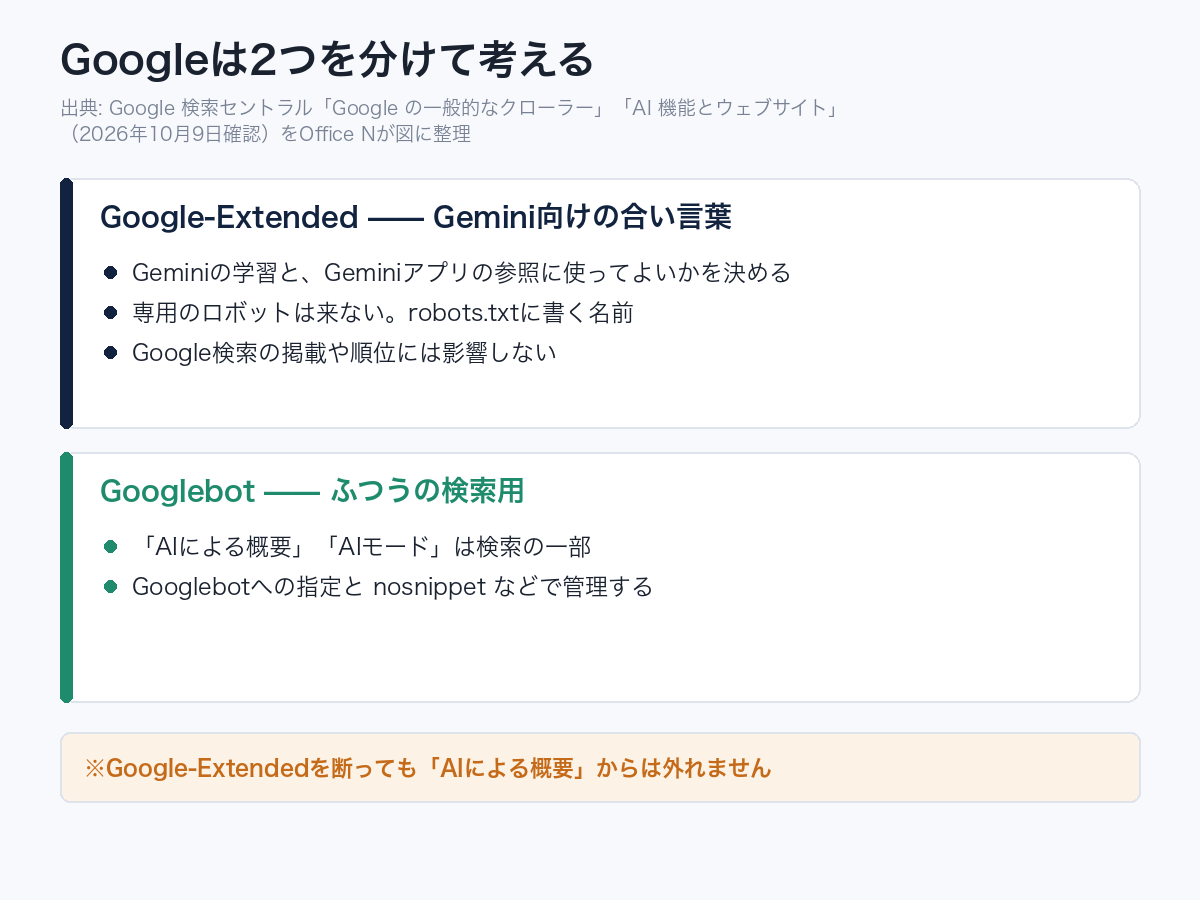
Googleは少し事情が違います。Googleの公式ページを読むと、2つを分けて考える必要があります。
- Google-Extended:Geminiのモデルの学習と、Geminiアプリが答えるときに検索の情報を参照するしくみ(グラウンディング)に、サイトの内容を使ってよいかを決めるための名前です。専用のロボットが来るわけではなく、robots.txtに書くための「合い言葉」として用意されています。Googleは、これがGoogle検索への掲載や順位に影響することはないと明記しています
- Googlebot:ふつうのGoogle検索のためのロボットです。検索結果の上に出る「AIによる概要」や「AIモード」は検索の一部なので、こちらはGooglebotへの指定と、検索結果に出す文章の量を決める設定(nosnippetなど)で管理する、と説明されています
つまり、Google-Extendedを断っても、検索結果の「AIによる概要」からは外れません。「AIによる概要」に出るかどうかを分けたい場合は、別の設定になります。くわしくはSearch Console「検索の生成 AI 設定」の解説をご覧ください。
うちはどうする?——3つの方針(Office Nの整理)
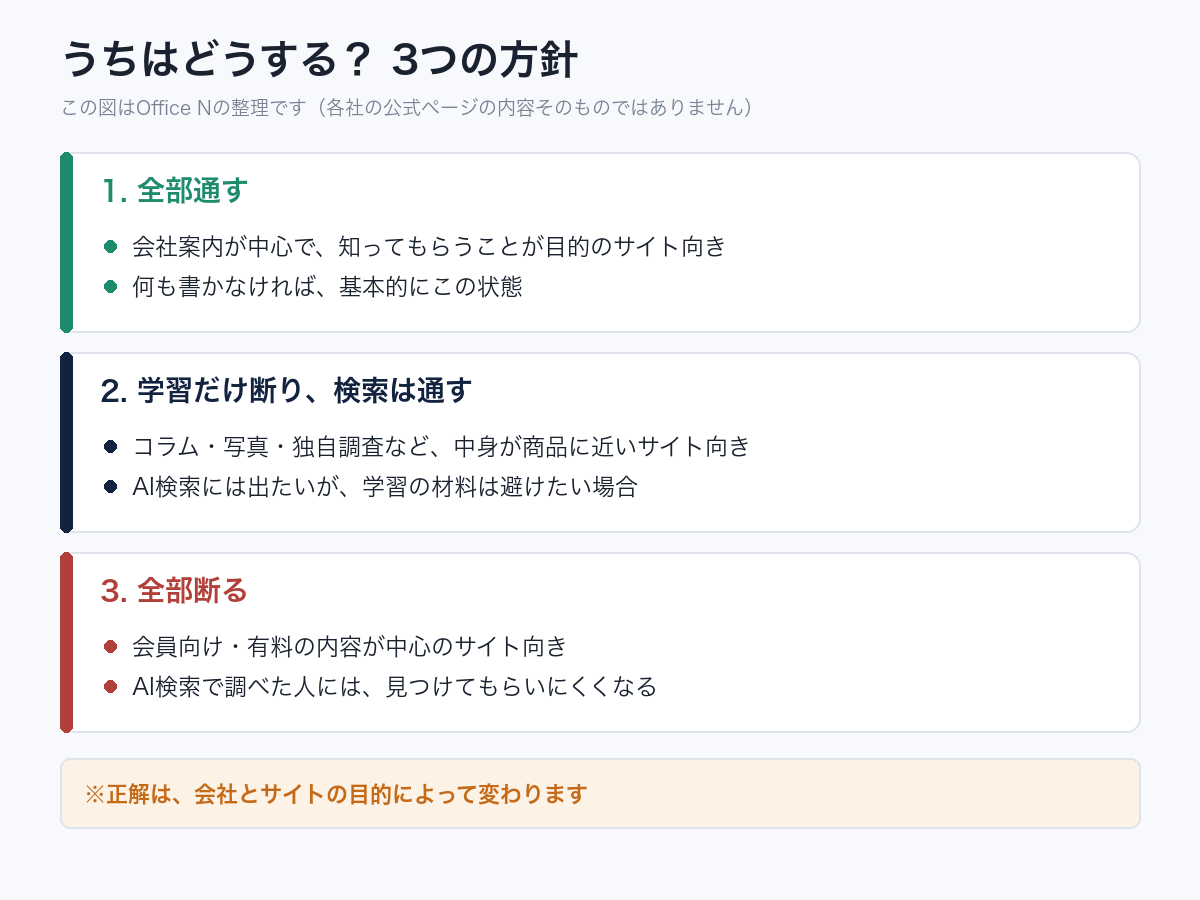
ここからは、3社の公式情報をふまえたOffice Nの整理です。小さな会社の選び方は、おおむね次の3つに分かれます。
- 全部通す:会社案内やサービス紹介が中心で、多くの人に知ってもらうことが目的のサイト向き。何も書かなければ、基本的にこの状態です
- 学習だけ断り、検索は通す:コラム、写真、独自の調査など、中身そのものが商品に近いサイト向き。AI検索には出たいが、学習の材料にされるのは避けたい、という場合です
- 全部断る:会員向けの記事や有料の内容が中心のサイト向き。ただし、AI検索で調べた人には見つけてもらいにくくなります
お客さんに見つけてもらうことが目的の会社のホームページなら、少なくとも検索用のロボットは通しておくのがよい、とOffice Nは考えています。AI検索で自社が出てこない原因は、ほかにもあります。AI検索で自社が見つからないときの確認ポイントもあわせてどうぞ。
robots.txtの見方と書き方——「学習は断る・検索は通す」の例
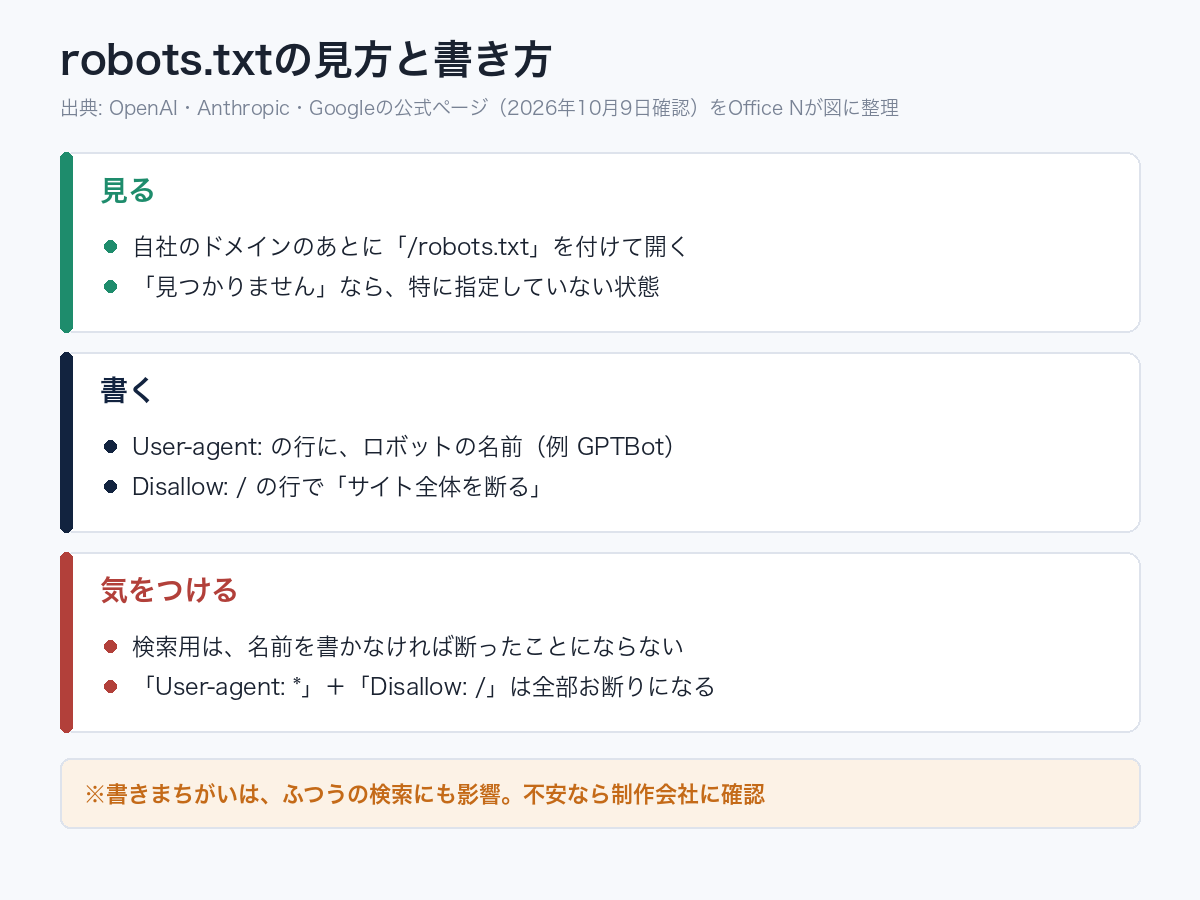
robots.txtは、サイトのいちばん上の階層に置く、文字だけの小さなファイルです。まずはいまの中身を見るところから始めます。
- ブラウザのアドレス欄に、自社のドメインのあとに「/robots.txt」と付けて開きます(例:https://自社のドメイン/robots.txt)
- 文字が表示されたら、それが今の指定です。「見つかりません」と出る場合は、ファイルが無い=特に指定していない状態です
- 中にGPTBot、ClaudeBot、Google-Extendedなどの名前があるか、「User-agent: *」のあとに「Disallow: /」(全部お断り)が書かれていないかを見ます
「学習は断る・検索は通す」にしたい場合の書き方の例です。1行目でロボットの名前、2行目で「/(サイト全体)を断る」と指定します。
User-agent: GPTBot
Disallow: /

User-agent: ClaudeBot
Disallow: /

User-agent: Google-Extended
Disallow: /検索用のOAI-SearchBotやClaude-SearchBotは、名前を書かなければ断ったことになりません。ただし、ファイルの中に「すべてのロボットを断る」指定(User-agent: * と Disallow: /)があると、検索用もまとめて止まってしまうので注意してください。
Anthropicのページには、サブドメイン(shop.自社のドメイン など)ごとにrobots.txtが必要なこと、巡回の間隔をあけてもらう指定(Crawl-delay)に対応していることも書かれています。
robots.txtの限界——やってはいけない3つ
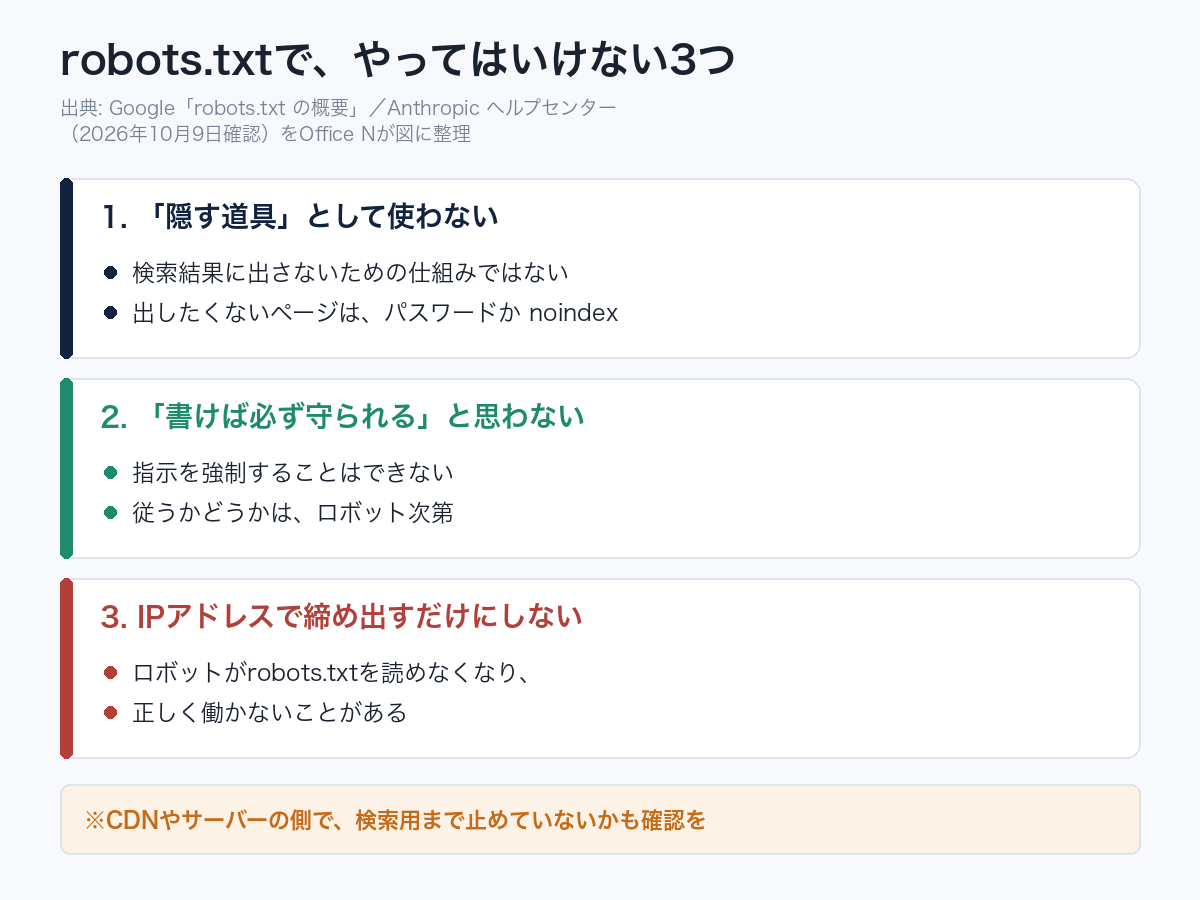
最後に、robots.txtに期待しすぎないための注意です。どれも公式ページに書かれている内容です。
- 「隠す道具」として使わない:Googleは、robots.txtは主にアクセスの集中を避けるためのもので、ページを検索結果に出さないための仕組みではない、と説明しています。出したくないページには、パスワードをかけるか、noindex(検索に載せない指定)を使うよう案内しています
- 「書けば必ず守られる」と思わない:Googleのページには、robots.txtの指示を強制することはできず、従うかどうかはロボット次第と書かれています。この記事で紹介した3社は、自社のロボットをrobots.txtで管理できると説明していますが、世の中のすべてのロボットがそうとは限りません
- robots.txtを書かずに、IPアドレスで締め出すだけにしない:Anthropicは、IPアドレスでのブロックはロボットがrobots.txtを読めなくなるため正しく働かないことがあり、断る意思表示がこの先も続く保証にならない、と説明しています
反対に、知らないうちに止めてしまっていることもあります。Googleは、検索のAI機能に出るための基本として、巡回がrobots.txtだけでなく、CDN(表示を速くする中継サービス)やサーバーの側でも許可されているかを確かめるよう挙げています。セキュリティの設定を強めたあとは、検索用のロボットまで止めていないか、一度見直すと安心です。
なお、「AI向けの説明ファイル(llms.txt)を置けば載る」という話については、llms.txtはどこまで本当かで公式の説明を整理しています。
出典(公式ページ)
- OpenAI「Overview of OpenAI Crawlers」https://developers.openai.com/api/docs/bots
- Anthropic ヘルプセンター「Anthropicはウェブからデータをクロールしていますか?サイト所有者はクローラーをブロックできますか?」(ページの日付:2026年4月7日)https://support.claude.com/ja/articles/8896518
- Google 検索セントラル「Google の一般的なクローラー」(Google-Extended の説明)https://developers.google.com/crawling/docs/crawlers-fetchers/google-common-crawlers?hl=ja
- Google 検索セントラル「AI 機能とウェブサイト」https://developers.google.com/search/docs/appearance/ai-features?hl=ja
- Google 検索セントラル「robots.txt の概要」https://developers.google.com/search/docs/crawling-indexing/robots/intro?hl=ja