

- Google・OpenAI・Microsoftが10月30日、ホームページの内容をAIの学習に使ってよいかどうかを、各社まとめて伝える共通の書き方に対応する方針を発表しました。Anthropicも実装を始めたと表明しています。
- 書くのはrobots.txtの2行だけです。ただし各社の対応はこれからで、仕組みもまだ草案の段階。お願いであって、強制力はありません。
- 多くの中小企業は急いで書く必要はありません。まず「学習」「回答の参照」「検索への掲載」の違いを知り、自社の方針を決めましょう。NoArchive・NoCacheを使っているサイトだけは、Bingの期限(2027年3月1日)に注意が必要です。
「うちのホームページの文章が、知らないうちにAIの学習に使われているのでは」「でも止めたら検索に出なくなるのでは」——こんな心配を聞くことが増えました。これまでは、止めたい場合はAIの会社ごとにロボットの名前を調べて、1社ずつ設定する必要がありました。
それを1つの書き方にまとめる動きが、10月30日に一気に進みました。この記事では、Google・OpenAI・Microsoftの発表と、インターネットの技術標準を話し合う団体IETF(アイイーティーエフ)に提出された文書を当社が原文で確認し、何が変わるのか、中小企業はどう判断すればよいかを整理します。
何が発表された?——AIの学習を「まとめて」断れる共通の書き方
発表の中身は、ホームページの設定ファイルrobots.txt(ロボッツテキスト)に、AIの学習について意向を伝える共通の書き方を用意し、各社がそれを尊重するというものです。robots.txtは、検索エンジンなどの巡回ロボットに「ここは見ないで」と伝えるためのファイルです。
Googleは公式ブログで、複数のAI提供企業に対して「in a single step(ひと手間で)」意向を伝えられるようになると説明しています。OpenAIも、これまで運営者はロボットを個別に調べて提供企業ごとにルールを管理する必要があったとし、共通の仕組みで負担を減らせると書いています。
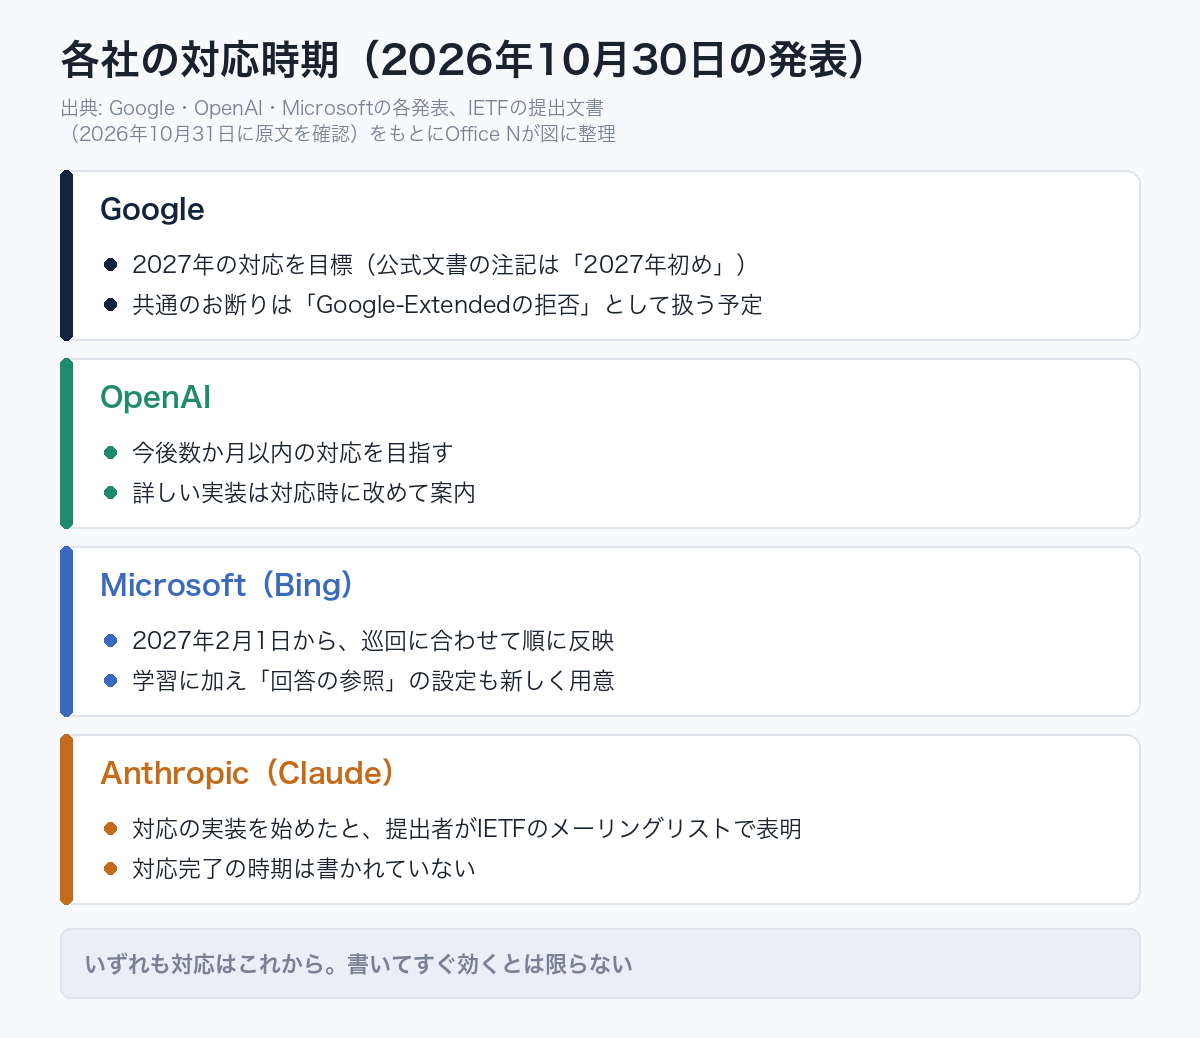
対応の時期は会社ごとに違います。
- Google:2027年に対応することを目標としています(公式文書の注記は2027年初め)
- OpenAI:今後数か月以内の対応を目指すとしています
- Microsoft(Bing):2027年2月1日から、ページを巡回するのに合わせて順に反映します
- Anthropic(Claude):文書の提出者でAnthropicに所属するKevin Kelley氏が、対応の実装を始めたとIETFのメーリングリストで表明しました。完了の時期は書かれていません
書き方はたった2行——「__usage_ai-training」
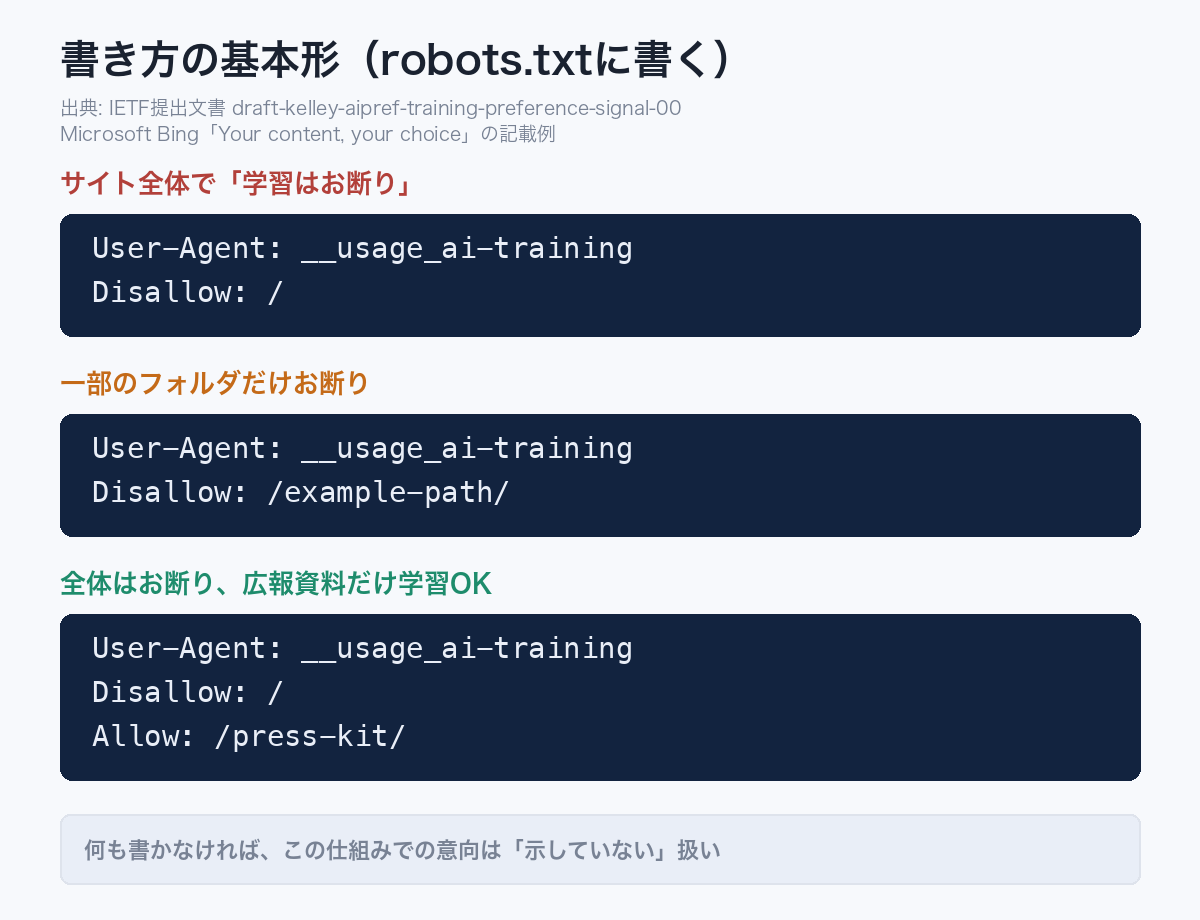
使う名前は__usage_ai-trainingです(先頭の下線は2本)。サイト全体で学習を断るなら、robots.txtに次の2行を書きます。
- 1行目:
User-Agent: __usage_ai-training - 2行目:
Disallow: /
ふつうのrobots.txtと同じ形なので、特定のフォルダだけを指定することも、全体は断って一部だけ認めることもできます。この名前は実在のロボットの名前ではなく、文書では「policy token(ポリシートークン)」と呼ばれています。ロボットの通行止めではなく、「内容の使い道についての意向」を伝える札のようなものです。
何も書かなかった場合、文書の上では「意向を示していない」扱いになります。Microsoftは、設定がなければ「Allow(許可)」が既定だと説明しています。つまり、書かないことで今の状態が急に悪くなるわけではありません。
「学習」「回答の参照」「検索への掲載」は別の話
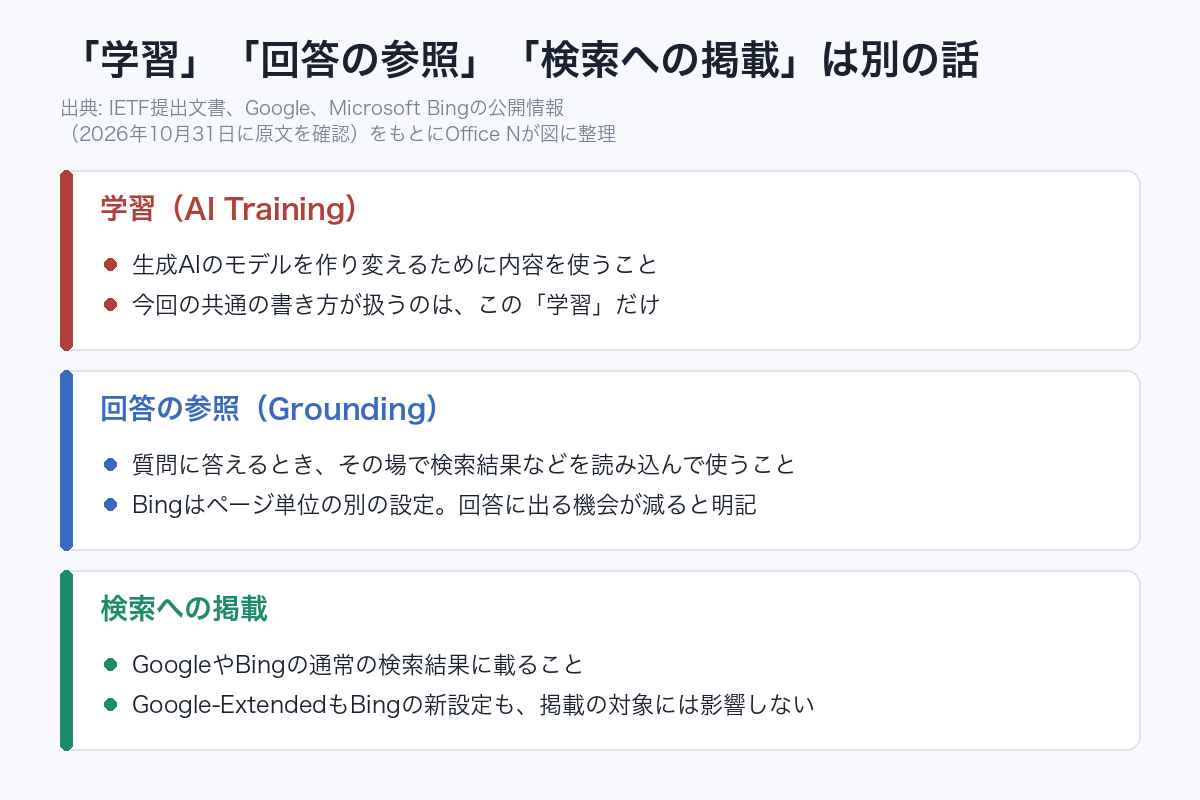
ここが一番大切なところです。AIとホームページの関係は、次の3つに分けて考えます。
- 学習:生成AIのモデルを作り変えるために内容を使うこと。今回の共通の書き方が扱うのは、この学習です
- 回答の参照(グラウンディング):質問に答えるとき、その場でWebの内容を読み込んで回答に使うこと
- 検索への掲載:GoogleやBingの通常の検索結果に載ること
Microsoftは今回、回答の参照についても新しい設定をページ単位で用意しました。ただし、参照を止めると「reduced brand visibility in AI experiences(AIの体験の中でブランドの見え方が減る)」と明記しています。一方で、学習も参照も、Bingの通常の検索結果に載る資格は変えないとしています。
Googleには注意点があります。共通の書き方で学習を断り、Google-Extended(Googleの従来のAI向け設定)を個別に指定していない場合、GoogleはそれをGoogle-Extendedの拒否として扱う予定です。Google-Extendedは将来のGeminiの学習だけでなく、Geminiアプリなどでの回答の参照にも関わる設定です。Googleの検索への掲載や順位には影響しないと公式文書に書かれています。Googleは、Google-Extendedを明示的に許可したサイトはGeminiアプリの参照の対象になると説明しているため、断るとGeminiアプリの回答に出にくくなる可能性があると当社は読んでいます。
うちはどうする?——3つの方針
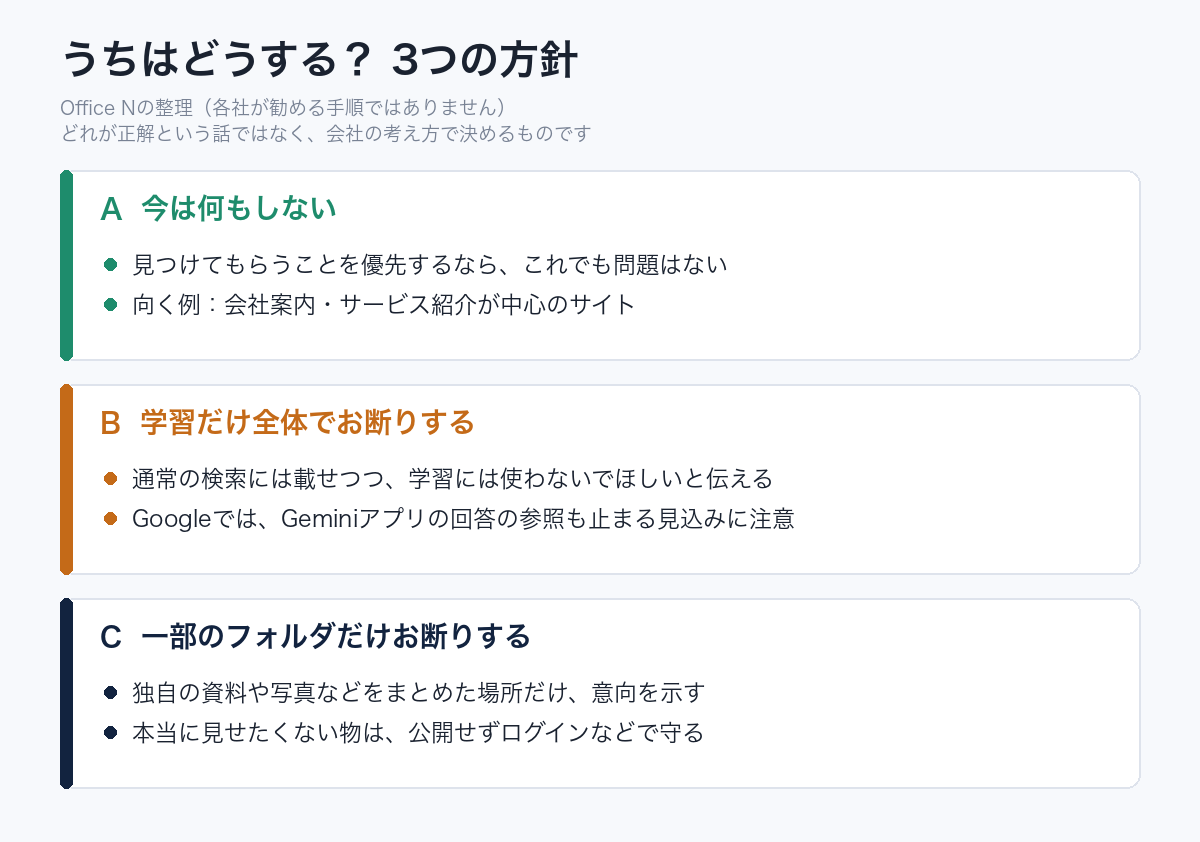
どれが正解というものではありません。以下は、Office Nが中小企業向けに整理した考え方です。
- A:今は何もしない:会社案内やサービス紹介が中心で、見つけてもらうことを優先するなら、これでも問題はありません。各社の対応が出そろってから考えても遅くはありません
- B:学習だけ全体で断る:通常の検索には載せたまま、学習には使わないでほしいと伝えます。ただし前の項目のとおり、GoogleではGeminiアプリの回答の参照にも影響する見込みです
- C:一部のフォルダだけ断る:独自の資料や写真をまとめた場所だけ意向を示します。会社紹介は見つけてもらい、大事な資料は守る、という分け方です
なお、許可したからといって得をするとも限りません。Microsoftは、学習や回答の参照を許可しても「Neither choice guarantees inclusion, traffic, or payment(掲載・アクセス・支払いのいずれも保証しない)」と書いています。本当に見せたくない情報は、robots.txtに頼らず、そもそも公開しない、ログインで守るといった対応が必要です。
従来の設定方法は引き続き使えます。Google・OpenAIとも、今回の共通の書き方は既存の設定に置き換わるものではないとしています。GPTBotなどのロボットごとの違いは「うちのホームページ、AIに読ませる? 止める?」で解説しています。
書く前に知っておきたい5つの注意
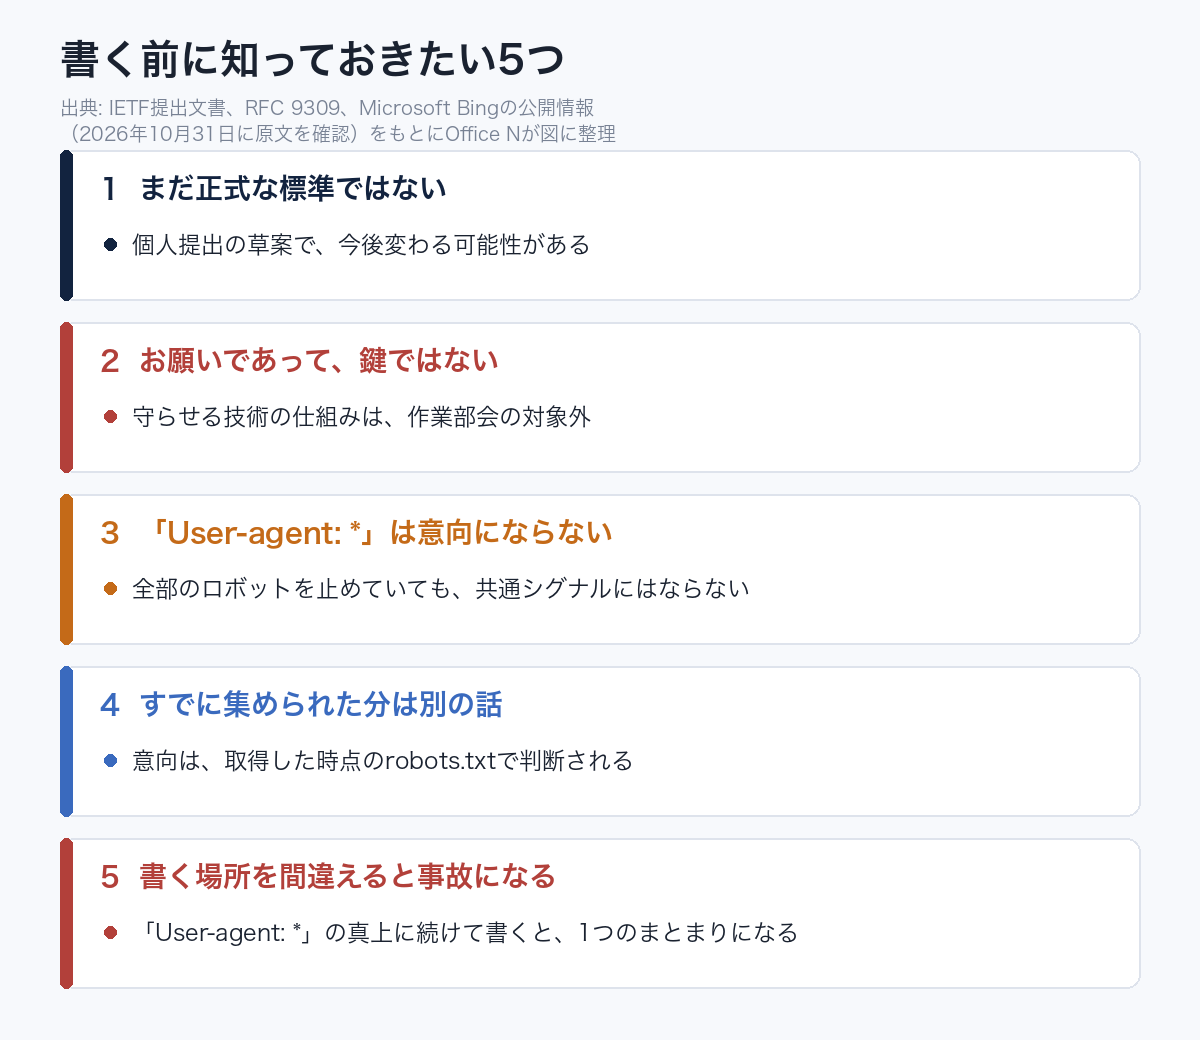
- まだ正式な標準ではありません:文書は個人提出の草案で、冒頭に「IETFが承認したものではない」旨が書かれています。有効期限は2027年5月3日で、内容が変わる可能性があります
- お願いであって、鍵ではありません:IETFの作業部会は、守らせるための技術的な仕組みを対象外としています。OpenAIも「自主的な取り組み」と書いています。対応していない会社には届きません
- 「User-agent: *」で止めていても、意向にはなりません:全ロボット向けの書き方は、共通の札には当てはまらないと定められています。意向を示すなら、札の名前を明記します
- すでに集められた分は別の話です:文書では、意向は内容を取得した時点のrobots.txtで判断するとされています。後から書いても、過去にさかのぼって取り消す仕組みとは書かれていません
- 書く場所を間違えると事故になります:robots.txtの決まりでは、User-agentの行が続くと1つのまとまりになります。たとえば「User-agent: *」のすぐ上に札の行を続けて書くと、下の「Disallow: /」が全部のロボットにも札にも効いてしまう書き方になりかねません。新しいまとまりは、ファイルの一番最後に書くのが安全です(当社の整理)
Bingの期限に注意——NoArchive・NoCacheを使っている場合
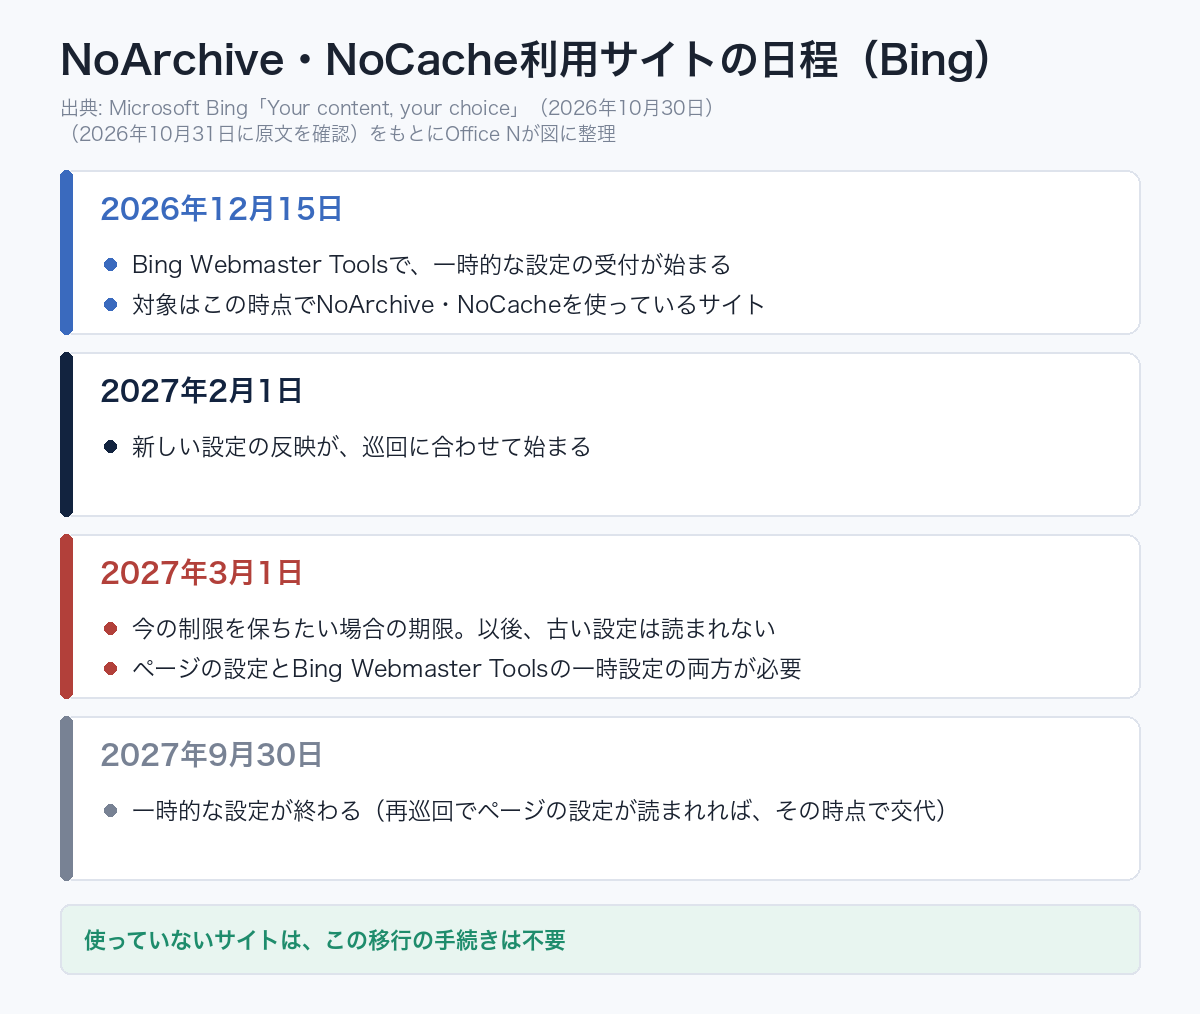
ほとんどの会社には関係ありませんが、ページにNoArchive・NoCacheという指定を入れている場合だけ、日程の確認が必要です。Microsoftはこの2つを、学習や回答の参照の制御として読むのをやめ、新しい設定に置き換えます。
- 2026年12月15日:Bing Webmaster Tools(Bingのサイト管理ツール)で一時的な設定の受付が始まります。対象はこの時点で2つの指定を使っているサイトです
- 2027年2月1日:新しい設定の反映が、巡回に合わせて始まります
- 2027年3月1日:今の制限を保ちたい場合の期限です。これを過ぎると、古い指定は読まれません
- 2027年9月30日:一時的な設定が終わります
手続きをしないと、対象のページは再巡回されるまで、回答の参照が「許可」の扱いになります。使っていないサイトは、この移行手続きは不要です。
今週できる点検の手順5つ
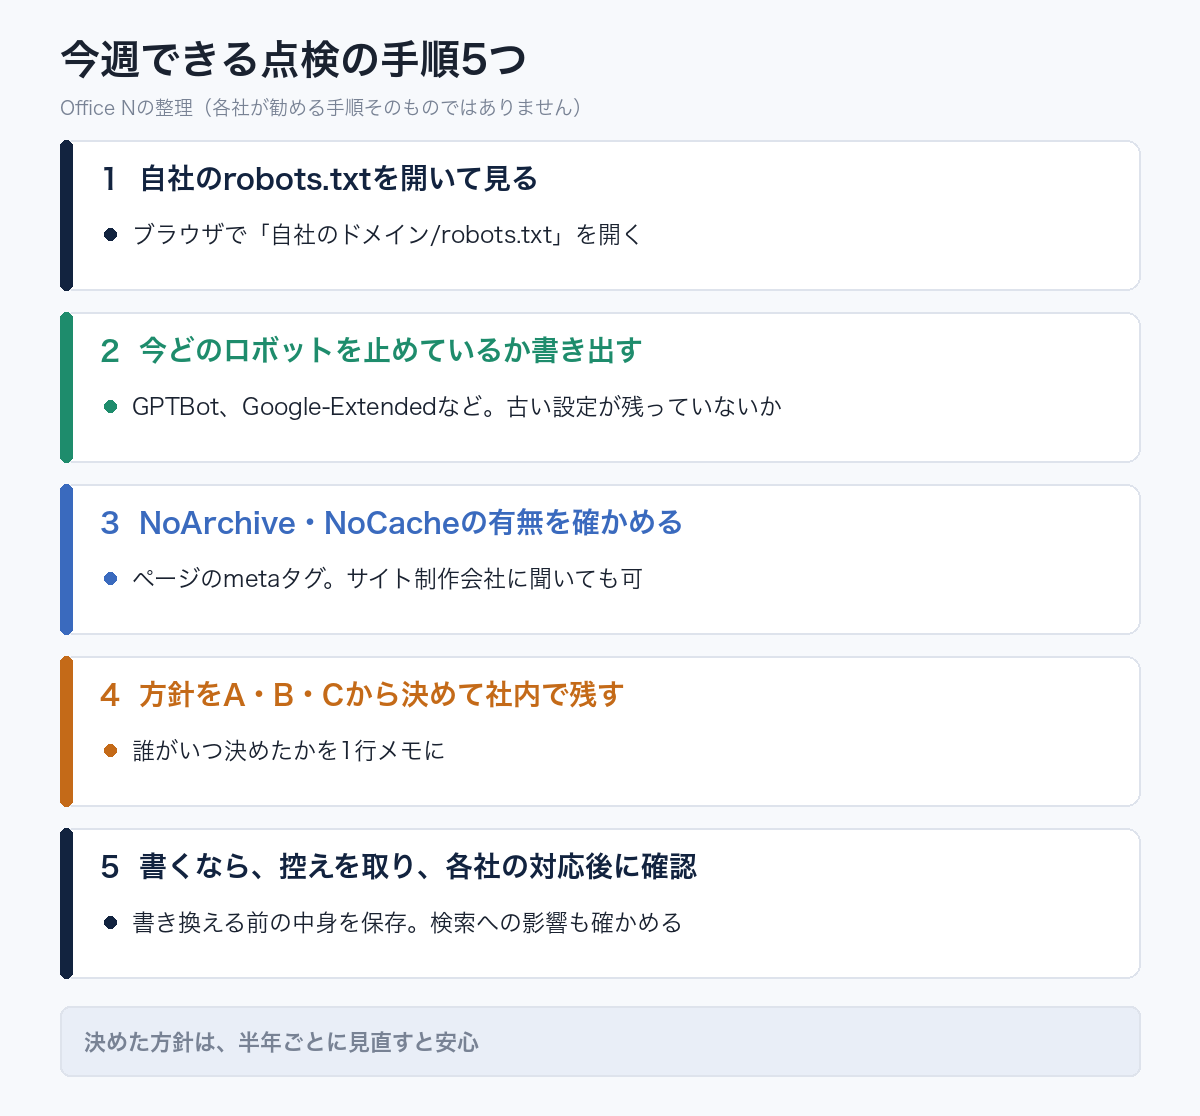
すぐに書き足す必要はなくても、自社の状態を知っておくことには意味があります。以下はOffice Nの整理で、各社が勧める手順そのものではありません。
- 自社のrobots.txtを開いて見る:ブラウザで「自社のドメイン/robots.txt」を開くと、誰でも中身を確認できます
- 今どのロボットを止めているか書き出す:GPTBotやGoogle-Extendedなど。過去の担当者や制作会社が入れた設定が残っていることもあります
- NoArchive・NoCacheの有無を確かめる:ページのmetaタグや制作会社への確認で調べます
- 方針をA・B・Cから決めて社内に残す:誰がいつ、なぜ決めたかを1行のメモにします
- 書くなら控えを取り、各社の対応後に確認する:書き換える前の中身を保存し、書いた後は検索での表示に変化がないかを確かめます
検索エンジンの表示を細かく調整する方法はnosnippetの解説記事、AI向けに話題のファイルについてはllms.txtの記事も参考になります。
まとめ
AIの学習についての意向を、robots.txtの2行で各社にまとめて伝える流れが始まりました。ただし、対応はこれからで、草案の段階で、強制力もありません。多くの中小企業に今必要なのは、急いで書くことより、「学習」「回答の参照」「検索への掲載」を分けて考え、自社の方針を決めておくことです。
Office Nでも、robots.txtの確認やAIに見つけてもらうためのサイト改善のご相談をお受けしています。
- Google Search Central Blog「Supporting a shared AI training control for websites」(2026年10月30日)
https://developers.google.com/search/blog/2026/10/ai-training-control - Google「Google の一般的なクローラ」(Google-Extendedの説明と注記)
https://developers.google.com/search/docs/crawling-indexing/google-common-crawlers - OpenAI「AI 学習への利用意向をウェブサイトが伝えやすくする仕組み」(2026年10月30日)
https://openai.com/index/helping-websites-express-ai-training-preferences - Microsoft Bing Blog「Your content, your choice: clearer preferences for training and grounding」(2026年10月30日)
https://blogs.bing.com/search/2026/10/your-content-your-choice-clearer-preferences-for-training-and-grounding/ - IETF Internet-Draft「Machine-Readable Training Preference Signal」draft-kelley-aipref-training-preference-signal-00(2026年10月30日)
https://datatracker.ietf.org/doc/draft-kelley-aipref-training-preference-signal/ - IETF ai-controlメーリングリスト「New draft: draft-kelley-aipref-training-preference-signal-00」(2026年10月30日)
https://mailarchive.ietf.org/arch/msg/ai-control/mddjatOxSR0h6GmLRBWlc839c7w/ - IETF「AI Preferences (aipref)」作業部会の憲章
https://datatracker.ietf.org/wg/aipref/about/ - RFC 9309「Robots Exclusion Protocol」
https://www.rfc-editor.org/rfc/rfc9309